Software

Value Iteration in Grid World
Bellman-Gleichung für Value Iteration:
V(s) = maxa Σs’ [P(s’|s,a) * (R(s,a,s’) + γ * V(s’))]
Wo:
- V(s) der Wert des Zustands s ist
- P(s’|s,a) die Übergangswahrscheinlichkeit ist (hier angenommen als deterministisch, daher = 1)
- R(s,a,s’) die Belohnung für die Übergangsfunktion von s nach s’ durch Aktion a ist
- γ (gamma) der Abzinsungsfaktor ist
- V(s’) der Wert des nächsten Zustands s’ ist
Belohnungswerte:
- Hindernisse haben eine Belohnung von -10
- Das Ziel hat eine Belohnung von 0, wenn es erreicht wird
- Normale Schritte haben eine Belohnung von -1
Optimale Wertfunktion
Optimale Politik
Explizit berechnete Werte
Erklärung des Prozesses:
Der Value-Iteration-Algorithmus wird verwendet, um die optimale Politik und Wertfunktion für eine gegebene Rasterwelt zu finden. Der Algorithmus iteriert über alle Zustände und berechnet die maximale erwartete Belohnung für jeden Zustand basierend auf möglichen Aktionen (gemäß der Bellman-Gleichung). Der Prozess dauert so lange, bis sich die Werteänderungen der Zustände unter einen bestimmten Schwellenwert (Theta) verringern. Hindernisse im Raster führen zu einer negativen Belohnung, während das Ziel eine neutrale Belohnung bietet, wenn es erreicht wird.
Erklärung des Codes:
- Zufällige Baumgenerierung:
- Ein zufälliger Graph wird mit 3 bis 8 Knoten erstellt.
- Die Kanten haben zufällige Gewichte zwischen 1 und 10.
- Eingabe einer Adjazenzmatrix:
- Der Benutzer kann eine Adjazenzmatrix eingeben, um einen konkreten Graphen zu definieren.
- Die Matrix wird als JSON-Array eingegeben (z. B.
[[0, 2, 0], [2, 0, 3], [0, 3, 0]]).
- Visualisierung:
- Der Graph wird mit vis.js dargestellt.
- Kanten des MST werden rot hervorgehoben.
- Algorithmus von Prim:
- Der Algorithmus wird schrittweise ausgeführt, und die Kanten des MST werden nacheinander angezeigt.
- Schrittweise Ausführung:
- Nach jedem Schritt wird der Graph aktualisiert, und es wird eine Pause von 1 Sekunde eingelegt.
Numerische Lösungsmethoden für ODEs
Vergleich von Euler- und Runge-Kutta-4-Methoden
- Eingabefeld für die DGL:
- Der Benutzer kann eine beliebige DGL der Form
y' = f(t, y)eingeben, z. B.-2 * y,t * y,Math.sin(t) * y, usw. - Die eingegebene DGL wird in eine JavaScript-Funktion umgewandelt.
- Der Benutzer kann eine beliebige DGL der Form
- Dynamische Aktualisierung:
- Wenn der Benutzer die DGL ändert, wird die Funktion
f(t, y)neu erstellt, und die numerischen Lösungen werden neu berechnet.
- Wenn der Benutzer die DGL ändert, wird die Funktion
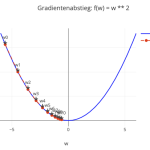
Gradient Descent Visualisierung
Interaktive Visualisierung des Gradientenabstiegsverfahrens
Beispiel:
- Geben Sie
w ** 2als Kostenfunktion ein, um das ursprüngliche Beispiel zu reproduzieren. - Ändern Sie die Kostenfunktion zu
Math.sin(w), um eine andere Funktion zu testen. - Passen Sie die Lernrate, die Anzahl der Iterationen und den Startwert an, um den Gradientenabstieg zu optimieren.
Interactive simulation of the Dennavit Hardenberg convention for open chain manipulators (robot arms)
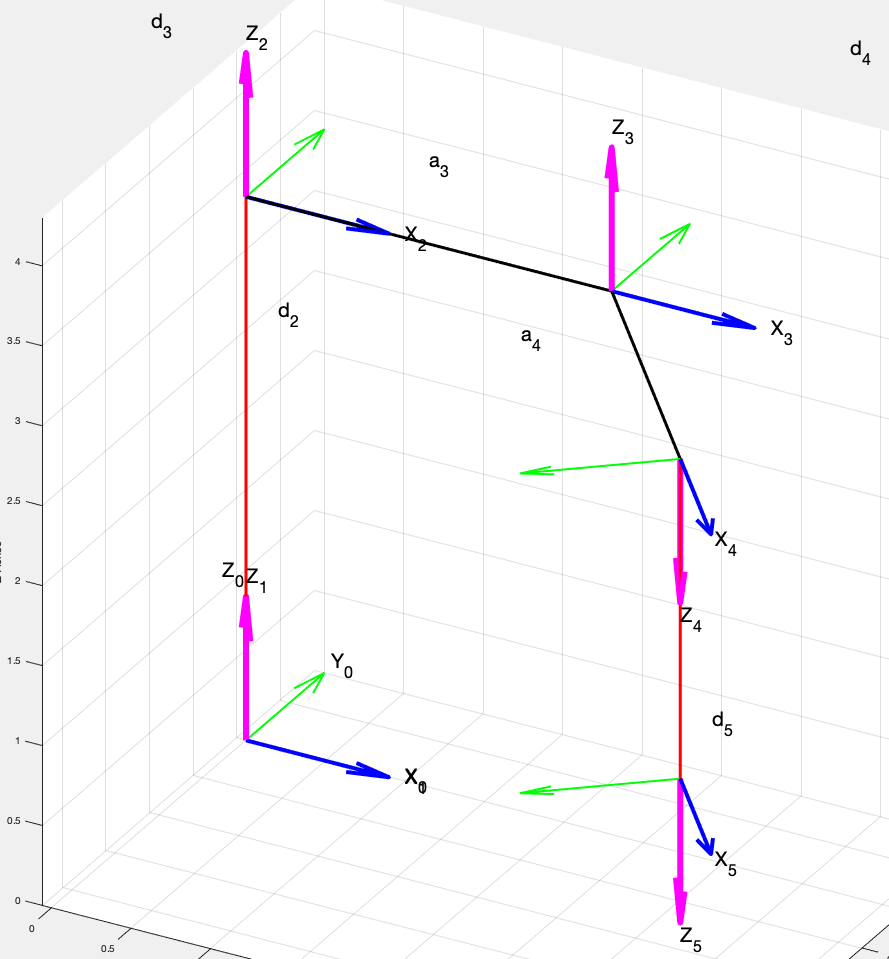
 Matlab simulator implementing the closed form solution for the inverse kinematics problem for multi redundant open chain manipulators.
Download-Link:
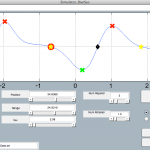
 The DynSys-Simulator implement a numerical solution for dynamical systems used in the attractor dynamics approach to robotics. Position, range and number of attractors and repellors can be changed interactively while the phase plot is updated in an closed loop. The simulator visualizes the behavior of the dynamical systems and can give an intuition how it is utilized for the generation of trajectories for mobile robots and redundant manipulators.
Download-Link: